CharsetFlow
一个面向 Windows 的本地批量文本编码转换工具,用来处理 UTF-8、GB18030、Big5、SHIFT-JIS 等不同编码以及 CRLF / LF 换行符转换。
GitHub:BeyondXinXin/CharsetFlow
1 项目定位
编码问题属于那种平时不显眼,一旦遇到就非常烦的开发问题。
尤其在 Windows 下维护旧项目、第三方代码、脚本或跨平台文本时,经常会同时碰到:
- UTF-8
- UTF-8 BOM
- GB18030
- Big5
- SHIFT-JIS
- UTF-16 / UTF-32
- Windows 系列编码
- CRLF / LF
单个文件用编辑器转换很简单,但如果是整个目录、几百个源码或配置文件,就需要一个更适合批处理的工具。
CharsetFlow 就是为这个场景写的。
2 核心功能
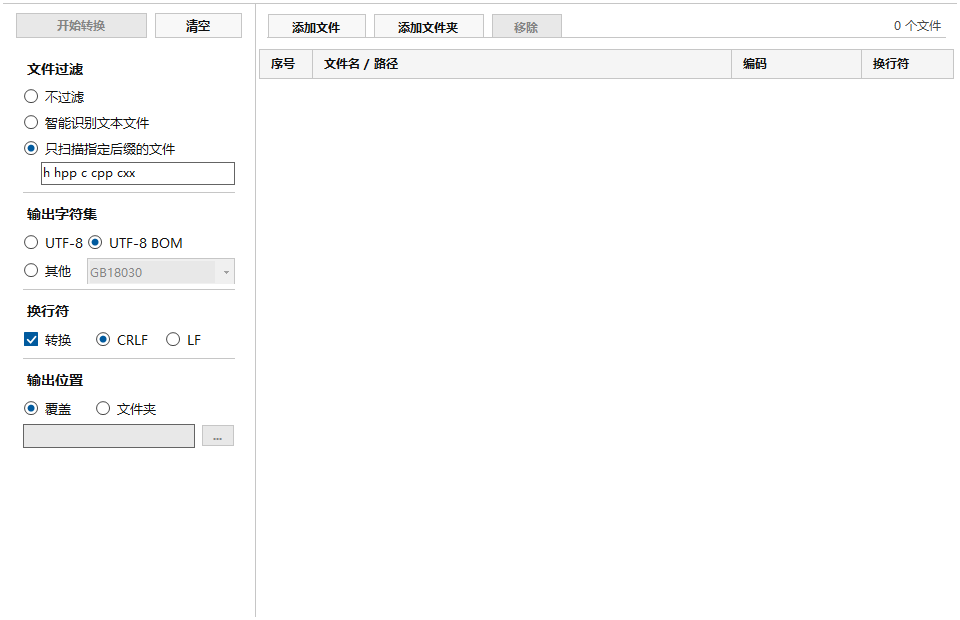
CharsetFlow 支持文件、文件夹和拖放添加,可以递归扫描目录,并通过扩展名规则控制哪些文件参与转换。
主要能力包括:
- BOM 编码识别
- 无 BOM Unicode 检测
- UTF-8 / UTF-8 BOM
- GB18030
- Big5
- SHIFT-JIS
- EUC
- Windows / ISO 系列编码
- 批量编码转换
- CRLF / LF 换行符转换
- 原位覆盖
- 输出到指定目录
- 原位转换前自动创建
.bak - 内容预览
- 手工指定源编码
- 异步探测
- 转换过程中取消任务
- 命令行模式
程序既可以当普通 GUI 工具使用,也可以直接从命令行参与脚本化处理。
3 编码检测
文本编码检测不存在一个对所有文件都百分之百可靠的算法。
CharsetFlow 没有把检测完全交给单一库,而是采用一套组合流程:
BOM
如果文件自身带 BOM,可以直接确认对应 Unicode 编码,这是最明确的一类情况。
严格 UTF 校验
对于没有 BOM 的文件,先检查其内容是否能够严格按照 UTF 编码解释,避免把明显合法的 UTF 文本交给概率探测器。
UTF.Unknown
对于剩余文本,再使用 UTF.Unknown 进行复合编码探测。
严格往返校验
探测出候选编码后,不只是“能解码就算成功”,还会进行严格解码、严格编码和 Unicode 往返校验,尽量避免转换过程中悄悄丢字符。
二进制排除
批量扫描目录时很容易把二进制文件一起扫进来,因此在最终纳入文本文件之前还需要做二进制排除。
4 为什么强调“不要静默损坏文件”
编码转换工具最危险的问题不是转换失败,而是:
看起来转换成功了,实际上已经有字符丢失。
如果一个编码器遇到无法表示的字符时自动使用 ? 或替代字符,程序仍然可能正常结束,但原始内容已经不可逆地损坏。
因此 CharsetFlow 对解码和编码都尽量采用严格模式,并增加往返校验。
对于原位转换,还可以自动生成 .bak 文件。
相比“尽可能转换成功”,我更希望它在无法确认安全时明确失败。
5 GUI 与 CLI
项目同时支持两种使用方式。
普通启动时进入 Windows Forms 图形界面,可以拖放文件和目录、预览内容并选择目标编码。
命令行模式可以直接用于批处理,例如:
CharsetFlow --input D:\input --target_charset "UTF-8 BOM" --target_linebreak LF --output_dir D:\output
或者原位转换:
这样既能满足偶尔手工处理,也可以放进自己的构建脚本或迁移流程。
6 技术栈
项目使用:
- C#
- .NET 10
- Windows Forms
- UTF.Unknown 2.6.0
目标平台为 net10.0-windows,最终发布为 Windows x64 自包含单文件程序。
主要工程结构:
GUI 和 CLI 共用底层编码识别与转换逻辑,避免形成两套实现。
7 适用场景
我主要把 CharsetFlow 用在这些场景:
- 老项目统一转 UTF-8
- Windows / Linux 工程换行符统一
- 批量处理第三方源码
- 检查某个目录里混杂的文本编码
- 将历史 GB 系列文件迁移到 Unicode
- 在脚本中批量转换配置文件
它并不试图替代编辑器,而是专门处理“数量多、规则统一”的文本转换任务。
8 项目总结
CharsetFlow 是一个很典型的桌面开发辅助工具。
它解决的问题不新,但如果把批量扫描、编码识别、严格校验、备份、预览、GUI 和 CLI 都做好,实际使用体验会比临时脚本稳定很多。
源码: